閲覧数 2,981
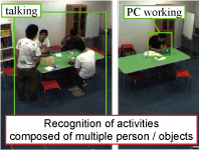
複数人で構成される行動(例えば「会話」)や,物体操作を伴う行動(例えば「PC作業」)のような行動を,カメラ画像から自動的に認識する手法の研究を行っています.
これら,複数人・物体といった複数構成要素を伴う行動は,同じ行動でも人の配置や物体と人との距離の変化により画像の差異が生じるため,これまで広く用いられてきた単一の画像テンプレートによる手法では困難な認識対象です.
本研究では,行動全体の見えに加えて,行動中の重要な局所領域を自動的に抽出し,その局所領域の見えと,平均位置からのずれ量を用いた認識を行うモデルを用いて,複数人・物体を伴う行動の認識手法を構築しました.
実験により,会話などの複数構成要素を持つ行動でも,提案手法で頑健に認識が可能であることが分かりました.